产品 · 配套系统 · 视觉识别模组
从图像到抓取位姿的完整感知链路
模组不只输出「有没有果实」,而是输出「哪一颗、熟没熟、在哪、什么姿态」——这四件事共同决定了机械臂能不能一次抓准。
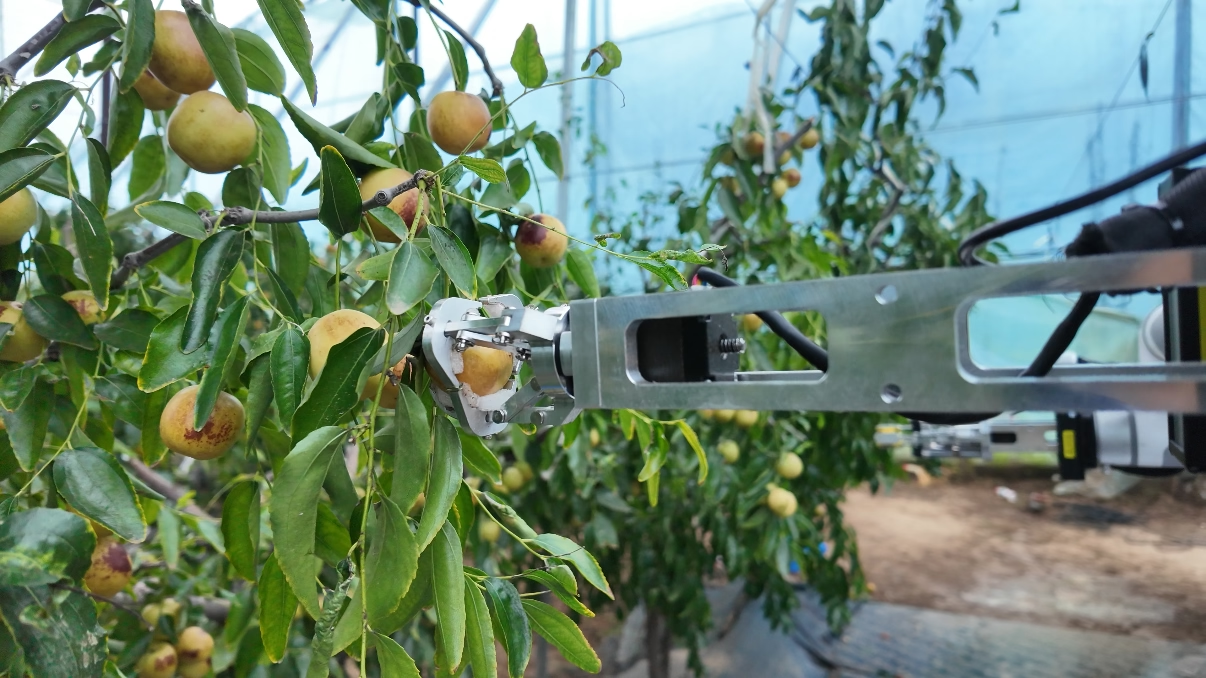
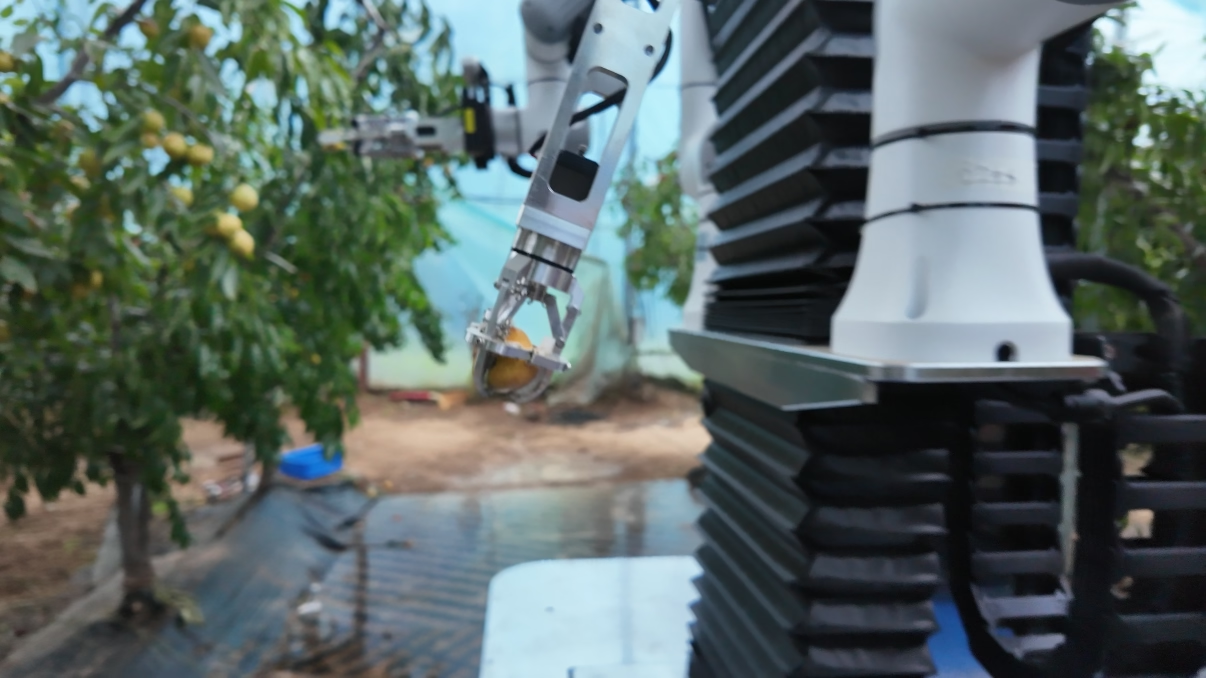
在真实果园里,视觉要面对的从来不是实验室条件:晨露反光、强逆光、棚内弱光、枝叶遮挡、果实成串分布同时存在。模组针对这些条件做了专门优化,冬枣场景实测识别精准度 96%,蓝莓场景 92%。
- 多品类识别:覆盖蓝莓、冬枣等品类,模型可按作物品类扩展
- 成熟度与果径判定:综合色泽、果径与表面特征输出可采摘果列表
- 抗复杂光照:晨露、强逆光、棚内弱光与夜间补光场景下稳定识别
- 遮挡与密植适应:枝叶遮挡、果实重叠、高密度种植条件下稳定检出
- 三维位姿输出:实时计算果实空间坐标与姿态,配合高精度手眼标定引导抓取
多光谱成像果实识别成熟度判定三维位姿手眼标定复杂光照适应
视觉识别模组 · 感知链路
图像采集层
多光谱成像 · 高灵敏度视觉传感器 · 棚内弱光与强逆光环境适配
预处理与增强
图像去噪与增强 · 光照归一化 · 遮挡区域分割
识别与判定层
深度视觉骨干模型 · 多品类果实检测 · 成熟度与果径判定
位姿估计层
三维位姿实时计算 · 高精度手眼标定 · 坐标系变换
输出与协同层
向双臂与末端执行器输出抓取位姿 · 引导手眼协同作业 · 作业数据回流农业大脑